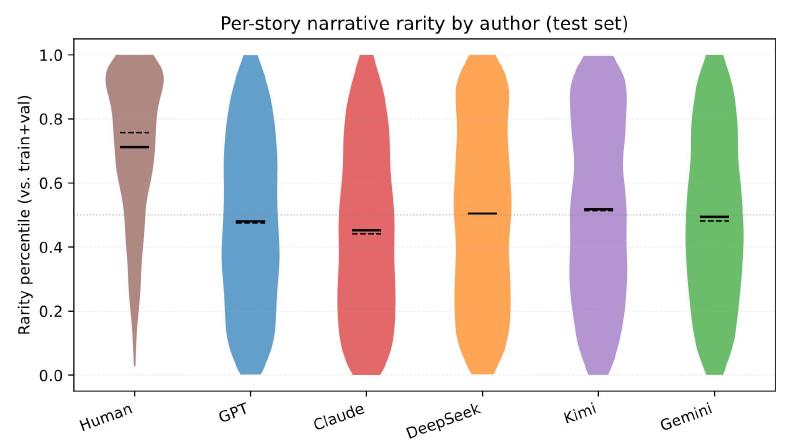
(Quelle: Russel et al, StoryScope: Investigating idiosyncrasies in AI fiction, arXiv:2604.03136)
Die Vorgeschichte #
Heute morgen begegnete mir ein Social-Media-Video1, in dem ein netter Brite eine Studie vorstellte, in der ein paar bunte Dönerspieße die unterschiedlichen Strukturen von KI-generierten Texten im Vergleich zu menschlicher Textarbeit darstellen sollten.
Mhh … Döner …
Es klang, wie immer bei KI-Beiträgen auf TikTok sehr klug und gelehrt und schlüssig. Und natürlich war es ohne Quellenangabe, weil: Warum auch?
Ich mag Originalquellen, also ging ich auf die Suche und die ersten Treffer waren natürlich weitere Social-Media-Beiträge, ebenfalls2 ohne3 Quellenangabe4.
Die Original-Studie #
Damit Ihr nicht auf das Hörensagen unseriöser Quellen vertrauen müsst, habe ich mir die Mühe gemacht und die Studie ermittelt, es ist diese hier:
StoryScope: Investigating idiosyncrasies in AI fiction
von Jenna Russell, Rishanth Rajendhran, Chau Minh Pham, Mohit Iyyer, John Wieting
https://arxiv.org/abs/2604.03136
Dabei handelt es sich um ein Preprint aus dem April. Man darf also gespannt sein, welche Wandlungen es noch durchlaufen wird.
Die Zusammenfassung #
Kernaussage #
Erkennung funktioniert auch ohne Stil: Allein anhand narrativer Merkmale (ohne Stilsignale) erreichten die Autor:innen 93,2% Makro-F15 bei der Unterscheidung Mensch vs. KI. Bei der Zuordnung zu einem von sechs Autor:innen (6-Wege-Klassifikation) waren es 68,4%.
Was zeichnet KI aus #
KI-Texte fallen dabei besonders durch folgende Merkmale auf:
- Überdeutlichkeit: KI erklärt Themen und Moral explizit (77% vs. 52% bei Menschen)
- Aufgeräumte Handlung: engere Kausalketten, weniger Nebenhandlungen (79% “keine Nebenhandlung” vs. 57%)
- Körperliche Emotionsdarstellung: Gefühle werden fast immer über Körperreaktionen gezeigt (81% vs. 38%), kaum benannt (nur 8% vs. 29% bei Menschen)
Narrativ schlägt Gedankenstrich #
Die Autor:innen argumentieren, dass narrative Merkmale ein haltbareres Erkennungssignal liefern als Stil, da Stil-Artefakte (z.B. Gedankenstriche, bestimmte Wörter) sich mit neuen Modellversionen schnell ändern, während strukturelle Erzählentscheidungen deutlich aufwendigere Überarbeitungen erfordern würden.Das ist schlüssig, denn jeder Influencer ist in der Lage, lange Gedankenstriche durch Doppelpunkte oder Semikolons auszutauschen, während ein origineller eigener Gedanke echte Arbeit am Text bedeutet.
Urheberrechtliches (ohne Rechtsberatung) #
Zudem verbindet das Paper seine Funde auch mit der rechtlichen Frage der Originalität, denn US-Urheberrecht verlangt “human creative control”.
Auch im deutschen Recht ist dies ein Thema, denn §2 UrhG knüpft Schutz an die “persönliche geistige Schöpfung und § 7 UrhG setzt als Urheber eine natürliche Person (“Schöpfer”) voraus, zumindest nach bisheriger Auffassung.6
Wenn eine Geschichte also fast vollständig von einer KI “konzipiert” wurde (Kernentscheidungen wie Plot, Zeitstruktur, Wendepunkte stammen von der KI), fehlt nach deutschem Recht vermutlich die geforderte persönliche geistige Schöpfung, selbst wenn ein Mensch den Text nachträglich stilistisch poliert hat. Die “Statistical Rarity” als Originalitäts-Proxy im Paper trifft auf die juristische Frage: “Wessen kreative Entscheidungen prägen das Werk wirklich?”
Die Lektüre lohnt. #
Der Preprint umfasst auch den Aufbau der Story-Pipeline und viele verwendete Prompts. Da wir alle ständig neue Promptideen haben, lohnt es sich also durchaus, selber mal das Paper samt Anlagen anzusehen.
AI writing has a shape, willfrancis24, 30.06.2026
https://www.tiktok.com/@willfrancis24/video/7657271508435242262 ↩︎Martin Galton auf LinkedIn, 30.06.2026
https://www.linkedin.com/posts/martingalton_human-writing-has-a-shape-no-ai-model-could-activity-7477654684049108992-0wXH/ ↩︎askryanlevesque auf Instagram, 16.06.2026
https://www.instagram.com/p/DZpde--Df1c/ ↩︎Damon Burton auf facebook, 23.06.2026
https://www.facebook.com/damon.burton/photos/ever-heard-of-the-bristol-stool-chart-its-a-medical-chart-used-to-classify-the-s/10162661419541034/
Der hier ist besonders amüsant, weil er als Quelle Ryan Levesque nennt, also den Instagram-Poster aus der vorhergehenden Fußnote. ↩︎Makro-F1 (Erklärung von Claude, Beleg von IBM) ist eine Metrik für generative KI-Qualitätsbewertungen mit mehreren Labels/Klassen, die misst, wie gut generative KI-Assets Entitätenextraktionsaufgaben für Vorhersagen mit mehreren Labels/Klassen ausführen.
Dabei wird für jede Kategorie (z. B. “Mensch” oder ein bestimmtes KI-Modell) getrennt der F1-Score berechnet – also das harmonische Mittel aus Präzision (Anteil korrekter positiver Vorhersagen) und Recall (Anteil tatsächlich erkannter Fälle) – und anschließend der ungewichteten Durchschnitt über alle Kategorien gebildet.
Im Gegensatz zu einer einfachen Gesamtgenauigkeit wird dabei jede Klasse gleich stark gewichtet, unabhängig davon, wie oft sie im Datensatz vorkommt; das ist besonders wichtig bei unausgewogenen Klassenverteilungen (wie hier, wo auf eine menschliche Geschichte fünf KI-Geschichten kommen), da sonst ein Modell, das einfach immer „KI” vorhersagt, fälschlich gut abschneiden würde. ↩︎Disclaimer: Dies ist keine Rechtsberatung!
Zudem werden wir hier, davon bin ich überzeugt, Änderungen sehen, denn die bisherigen Grundannahmen des Urheberrechts tragen im Hinterkopf immer noch Fotokopierer und Faxgeräte wenn sie über die Grenze zwischen Mensch und maschineller Reproduktion nachdenken. Das wird man an die neue Realität anpassen müssen. ↩︎